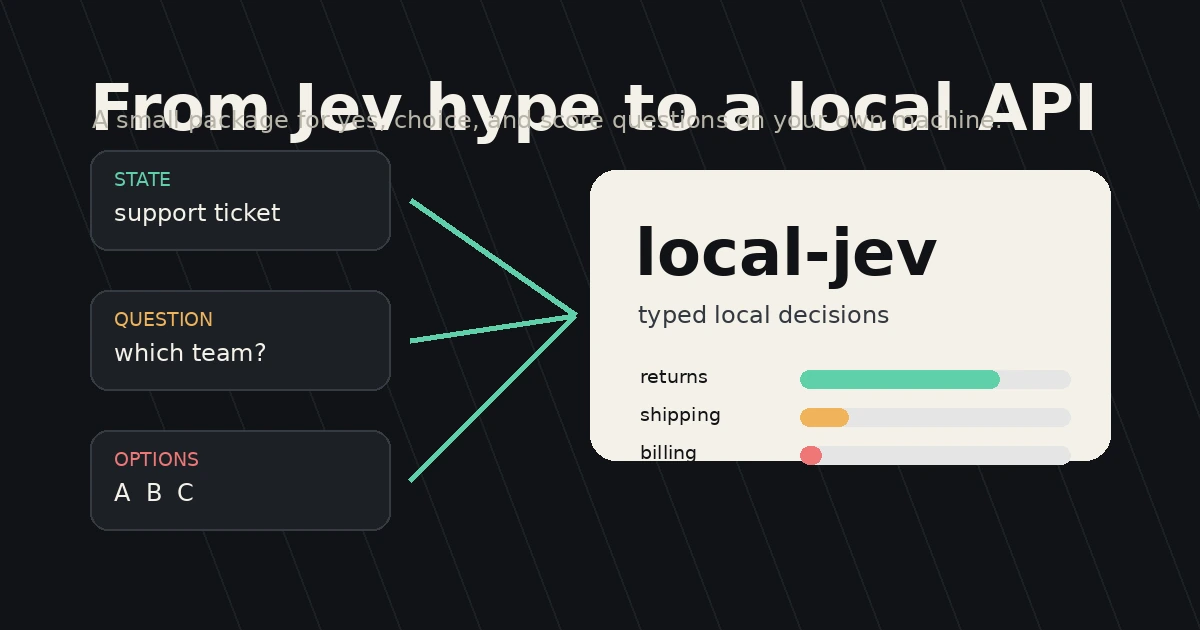
Ich sah ein Two Minute Papers Video über Jev und hatte sofort dieses merkwürdige Gefühl: Der interessante Teil war kleiner als der Hype und zugleich nützlicher. Wenn man daraus nur die nächste Geschichte über ein magisches Modell macht, verpasst man den praktischen Kern. Viele Modellaufrufe sollen nicht schreiben. Sie sollen zwischen klaren Antworten entscheiden.
Zwei kurze Fragen Ein Support-Ticket braucht nicht immer einen Absatz. Manchmal braucht es nur eine Route. Eine Deployment-Notiz braucht nicht unbedingt eine Zusammenfassung. Sie braucht vielleicht nur ein Ja oder Nein, ob der Rollout gelungen ist. Ein Agent vor einem Tool-Aufruf braucht nicht noch einen Chat-Kommentar. Er braucht vielleicht eine Prüfung mit drei möglichen Ausgängen.
Der erste lokale Hinweis Das erste Projekt, das sich in dieser Richtung wirklich praktisch anfühlte, war Kev, Jared Palmers kleine Jev-artige Decision-Model-Familie. Kev stellt genau solche Fragen: noul für Ja oder Nein, choice für eine feste Optionsliste und score für eine geordnete Bewertung. Im lokalen Test wirkte es anders als ein Chatmodell. Es wollte keine Unterhaltung führen. Es machte aus Evidenz und Frage Wahrscheinlichkeiten.
Kev ist wichtig, weil es nicht nur ein Prompt-Wrapper ist. Es basiert auf Qwen3.5-Modellen, trainierten Adaptern und einem Decision-Readout für genau diese Art von Anfrage. Damit ist Kev eine deutlich treuere offene Rekonstruktion des Jev-Musters als ein allgemeines Modell mit gutem Prompt. Für mich war die Frage danach: Wenn Kev der trainierte lokale Weg ist, kann es auch einen winzigen Zero-Shot-Weg geben, der die gleiche Schnittstelle schnell ausprobierbar macht?
Eine praktische Lücke Die Lücke lag in der Verpackung. Kev ist ein echter lokaler Weg, aber ich wollte ein kleines installierbares Projekt, das man auf einer normalen Linux-Maschine sofort ausprobieren kann. Ein Befehl für den Download, ein lokaler Server, eine vertraute API. Dann fand ich SemIf, ein offenes Projekt rund um denselben Semantic-if-Ansatz mit GGUF-Modellen. Damit war der Weg klar: Schnittstelle behalten, llama.cpp nutzen, die Logits der Antwortbuchstaben lesen, Wahrscheinlichkeiten zurückgeben.
Das Ergebnis heißt local-jev Das Ergebnis heißt local-jev. Es verwendet keine TypeSafe-Gewichte und hat keine TypeSafe-Verbindung. Es ist ein lokales Jev-artiges Paket: local-jev setup erstellt eine kleine Runtime und lädt ein offenes GGUF-Modell, local-jev serve startet danach eine API unter /v1/systemone. Das Standardmodell ist Qwen3 0.6B als Q4_K_M, etwa 484 MB. Für bessere Qualität gibt es zusätzlich ein größeres Qwen3.5 4B Preset.
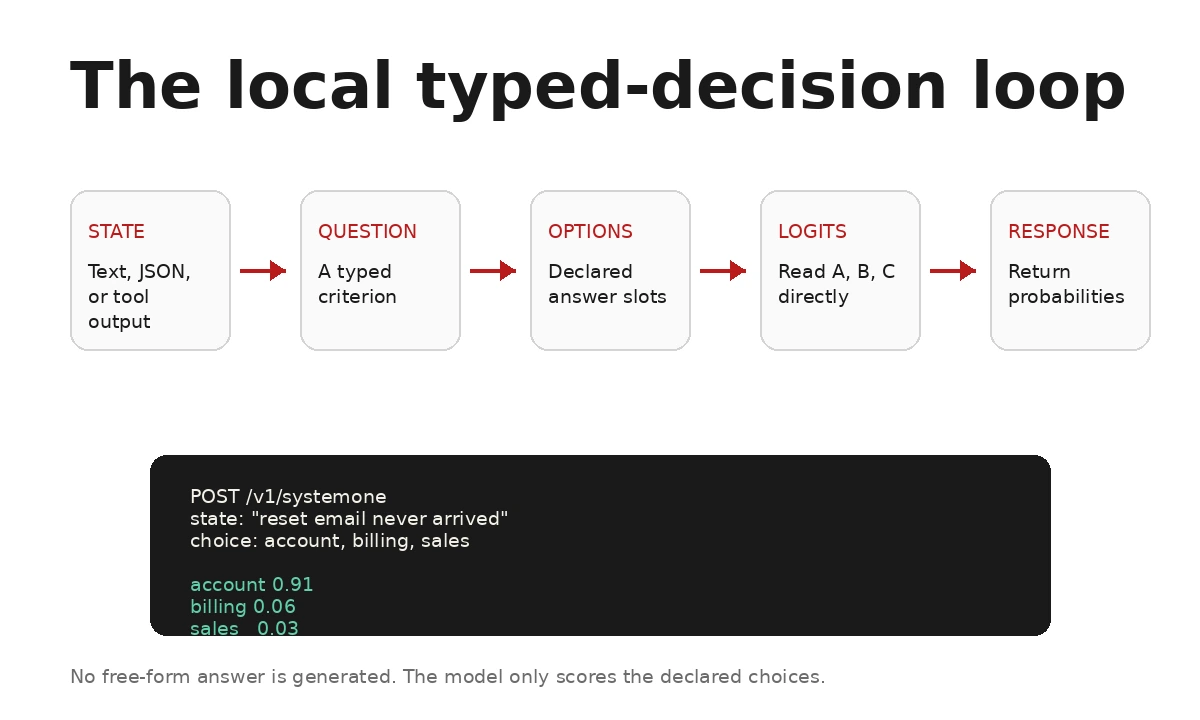
Die Form zählt Der Server nimmt immer dieselbe Form an. Man sendet state und eine Liste von Fragen. Jede Frage sagt, ob sie noul, choice oder score ist, und deklariert die erlaubten Antworten. Das Modell erfindet kein JSON-Schema. Es sieht Evidenz, Kriterium und Antwortplätze von A bis P. local-jev liest die Logits dieser Buchstaben, wendet Softmax an und liefert die Verteilung zurück.
Was ein Logit ist Bevor ein Sprachmodell Text schreibt, bewertet es jeden möglichen nächsten Token. Diese Rohwerte heißen Logits. Normale Generierung macht daraus wiederholt Text: nächsten Token bewerten, Token wählen oder sampeln, anhängen und weiterrechnen. Ein normaler Structured-Output-Wrapper lässt das Modell oft etwas wie {"choice":"billing"} schreiben und versucht danach, diesen Text zu parsen.
local-jev stoppt vor diesem Schreibschritt. Es baut einen Prompt, dessen Antwort einer der Buchstaben sein muss, führt das lokale GGUF-Modell einmal aus, liest nur die Logits der erlaubten Buchstaben und normalisiert diese Werte zu Wahrscheinlichkeiten. Die JSON-Antwort kommt aus dem Servercode, nicht aus dem Modell. Das ist der Kernunterschied: darunter liegt ein normales lokales LLM, aber es wird als Decision-Scorer genutzt und nicht als Prosa-Generator.
Der Vorteil ist Kontrolle. Das Schema ist fest, kaputtes JSON muss nicht repariert werden, das Ergebnis enthält eine Optionsverteilung und das Modell kann keinen Zusatztext anhängen. Der Nicht-Vorteil ist genauso wichtig: Die Scores sind nicht automatisch kalibriert, Formulierung und Optionsreihenfolge können zählen, und ein kleines allgemeines Modell hat die Decision-Aufgabe nicht so gelernt wie Kev. Deshalb nenne ich es Jev-artig. Es approximiert den typisierten Readout, behauptet aber nicht, Jev zu sein.
curl -s http://127.0.0.1:8010/v1/systemone \
  -H 'content-type: application/json' \
  -d '{"state":"reset email never arrived",
       "questions":{"route":{"type":"choice",
       "instructions":"Which queue should handle this?",
       "criteria":{"account":"login and access",
                   "billing":"payment or invoice",
                   "sales":"buying or evaluation"}}}}'
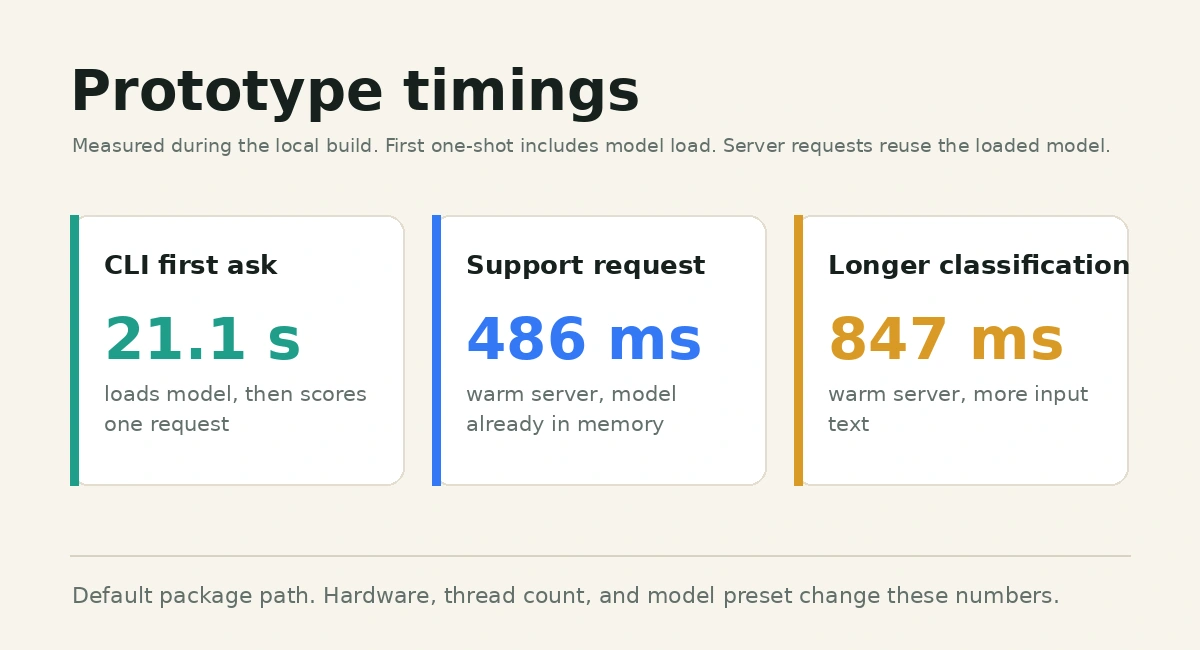
Auf der Maschine Auf einer lokalen CPU-Maschine dauerte der erste CLI-Aufruf etwa 21 Sekunden, weil das Modell geladen werden musste. Sobald der Server das Modell im Speicher hatte, war der nützliche Pfad deutlich schneller: eine Support-artige Anfrage mit drei Fragen brauchte etwa 486 ms, eine etwas längere Klassifikation etwa 847 ms. Das .deb selbst ist nur ungefähr 15 KB groß, weil das Modell erst beim Setup geladen wird.
Ein kleiner Benchmark Danach habe ich das Paket mit 100 generischen Support-Routing-Nachrichten getestet: je 25 für Account, Billing, Shipping und Technical. Genutzt wurde das Standard-Preset Qwen3 0.6B Q4_K_M auf einem warmen lokalen Server mit vier festen Antwortoptionen. Das ist ein Smoke-Test, kein wissenschaftlicher Benchmark.
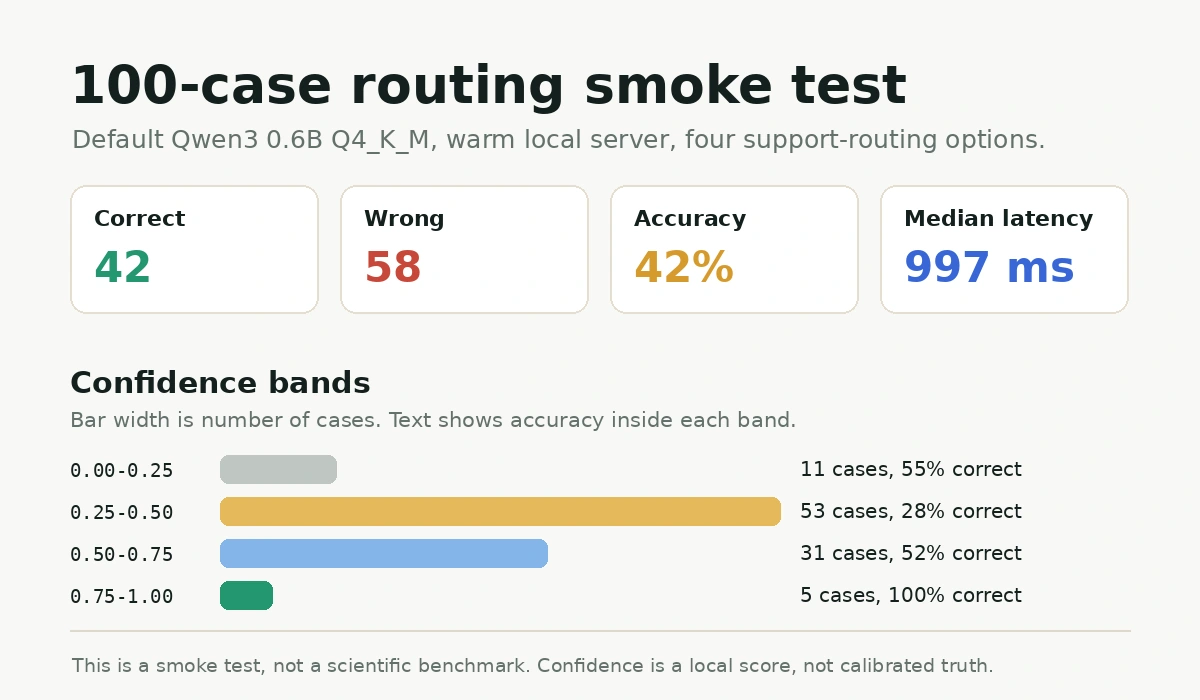
| Metrik | Ergebnis |
|---|---|
| Fälle gesamt | 100 |
| Richtig | 42 |
| Falsch | 58 |
| Accuracy | 42% |
| Mittlere gewählte Wahrscheinlichkeit | 0.587 |
| Mittlere Confidence | 0.450 |
| Mittlere Confidence bei richtigen Antworten | 0.491 |
| Mittlere Confidence bei falschen Antworten | 0.420 |
| Median-Latenz | 997 ms |
| 95. Perzentil der Latenz | 2389 ms |
| Confidence ≥ 0.75 | 5 Fälle, 100% richtig |
Nach Labeln waren es Account 18/25, Billing 9/25, Shipping 2/25 und Technical 13/25. Das ist nicht gut genug, um es schönzureden. Es zeigt genau, wo dieser Zero-Shot-Ansatz am schwächsten ist: Das kleine Standardmodell hatte einen deutlichen Bias zur ersten Option, besonders gegen Shipping. Confidence half nur ganz oben. Die meisten Anfragen lagen unter 0.75 Confidence, und die mittleren Confidence-Bänder waren verrauscht. Der Score ist also ein Signal für Gates und Validierung, kein Wahrheitsmesser.
Wofür es taugt Die guten Anwendungsfälle sind angenehm unspektakulär: Ticket-Routing, Policy-Prüfungen, Triage, Relevanzchecks, Deployment-Erfolg, Konfidenzbänder vor Automatisierung und Agent-Gates vor Tool-Aufrufen. Das Muster ist stark, wenn sich die Entscheidung als kleine Optionsliste schreiben lässt und Wahrscheinlichkeiten wichtiger sind als Prosa.
Die Grenze Die Grenze ist wichtig. Das Standardmodell ist klein und kann zu selbstsicher sein. Die Wahrscheinlichkeiten sind Optionsscores, keine gemessene Wahrheit. Ein größeres Modell kann helfen, ersetzt aber keine Validierung. Ich sehe local-jev als billige lokale Decision-Primitive, nicht als Orakel.
Ein kleines nützliches Ding Mir gefällt daran, dass aus der Jev-Diskussion etwas Testbares wird. Installieren, Anfrage senden, Wahrscheinlichkeiten anschauen und entscheiden, ob die Schnittstelle zum eigenen Workflow passt. Vielleicht gehören spezialisierte gehostete Decision-Modelle zur Zukunft. Vielleicht brauchen viele lokale Werkzeuge auch nur genau das: feste Antworten, ein lokales Modell und eine schnelle Wahrscheinlichkeitsschätzung.